
E022_Instruct GPT: Alinear la Ia es mejor que escalarla
Sobre este episodio
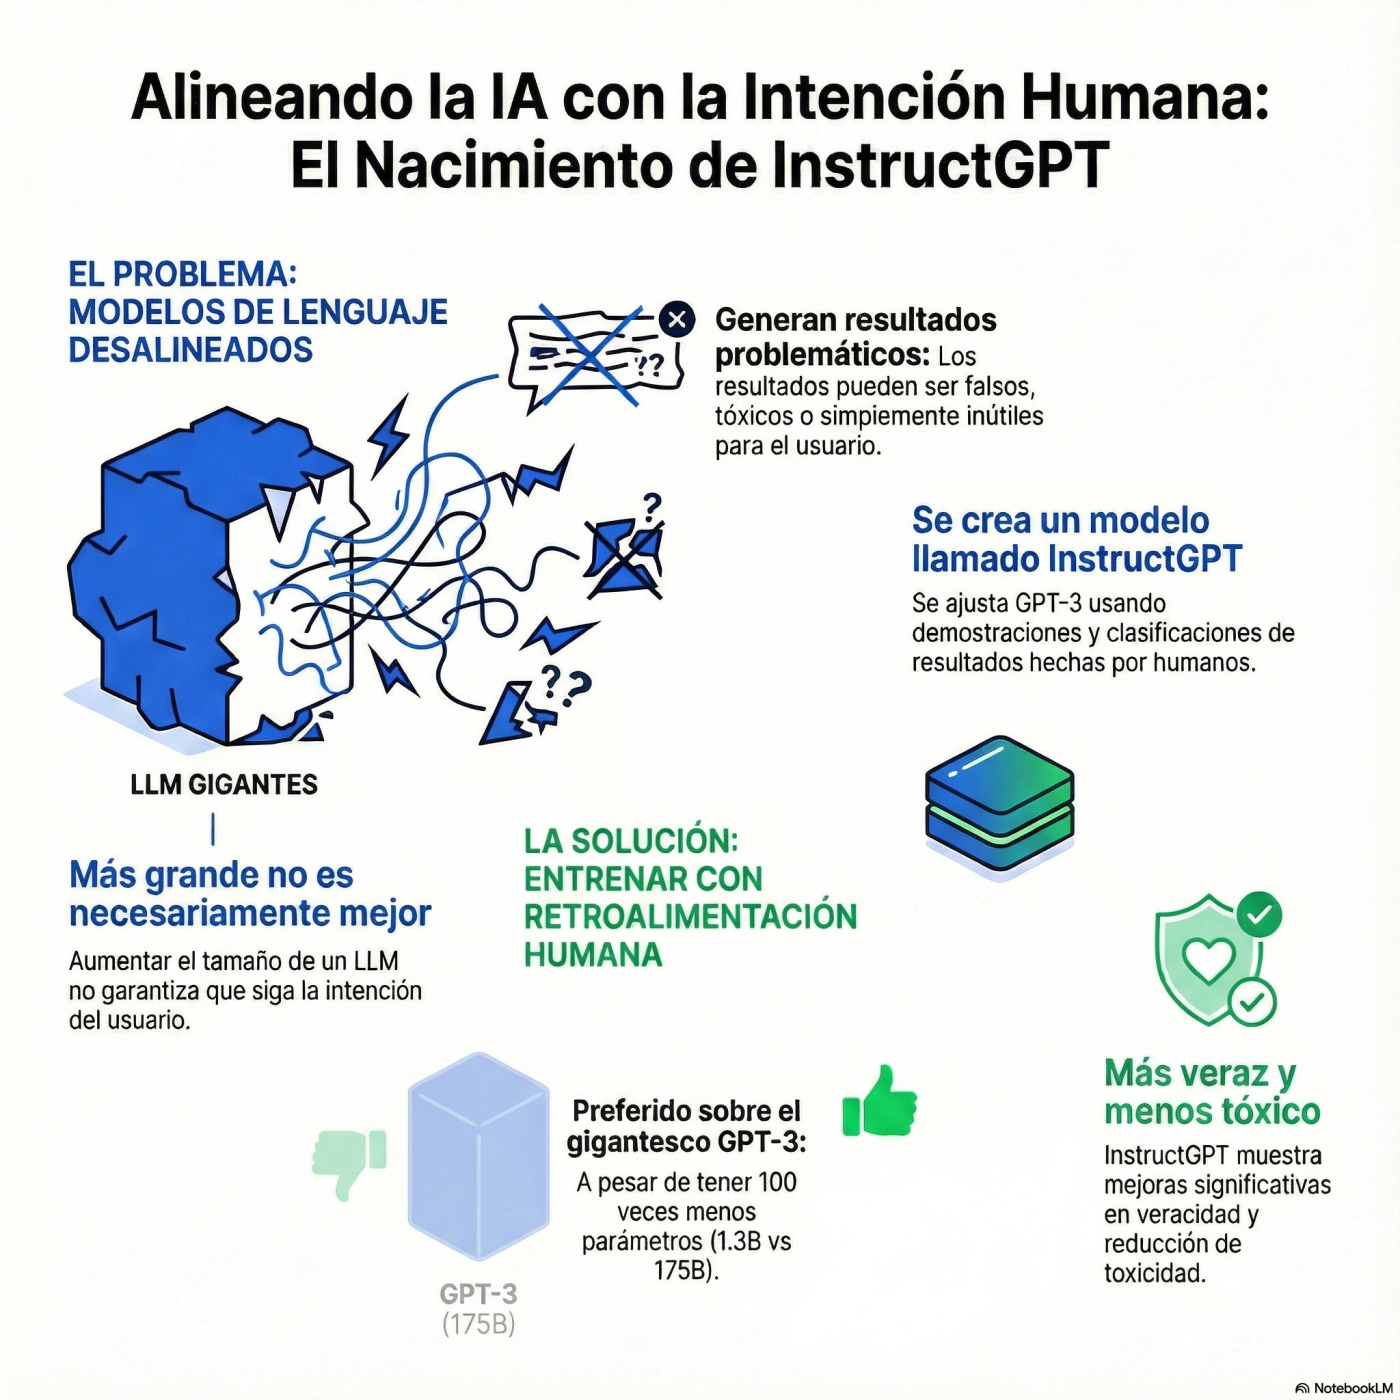
“¿Sabías que hacer más grandes a los modelos de lenguaje no los hace necesariamente mejores siguiendo instrucciones? 🤖 En este episodio desgranamos el paper fundamental que cambió el rumbo de la inteligencia artificial moderna: “Training language models to follow instructions with human feedback”. Analizamos por qué los modelos masivos, como el GPT-3 original, a menudo fallaban al generar respuestas veraces o útiles, llegando incluso a ser tóxicos si no estaban correctamente alineados con la intención del usuario. 🛡️ Exploraremos la paradoja de cómo el simple aumento de parámetros no garantiza una IA más servicial y segura. Descubre la metodología detrás de InstructGPT y cómo el uso de feedback humano mediante aprendizaje supervisado y por refuerzo marcó un antes y un después. 🚀 Profundizaremos en un dato revelador: cómo un modelo 100 veces más pequeño (1.3B de parámetros) logró superar al gigante GPT-3 (175B) en las preferencias de los usuarios, ofreciendo respuestas más certeras y menos tóxicas. ¡Dale al play ▶️ para entender cómo pasamos de máquinas que solo predicen texto a asistentes que realmente comprenden lo que les pedimos! 🧠✨ Fuentes: • Training language models to follow instructions with human feedback (ArXiv)”