
E023_Muñecas rusas o Cómo esconder IAs gigantes en embeddings diminutos
Sobre este episodio
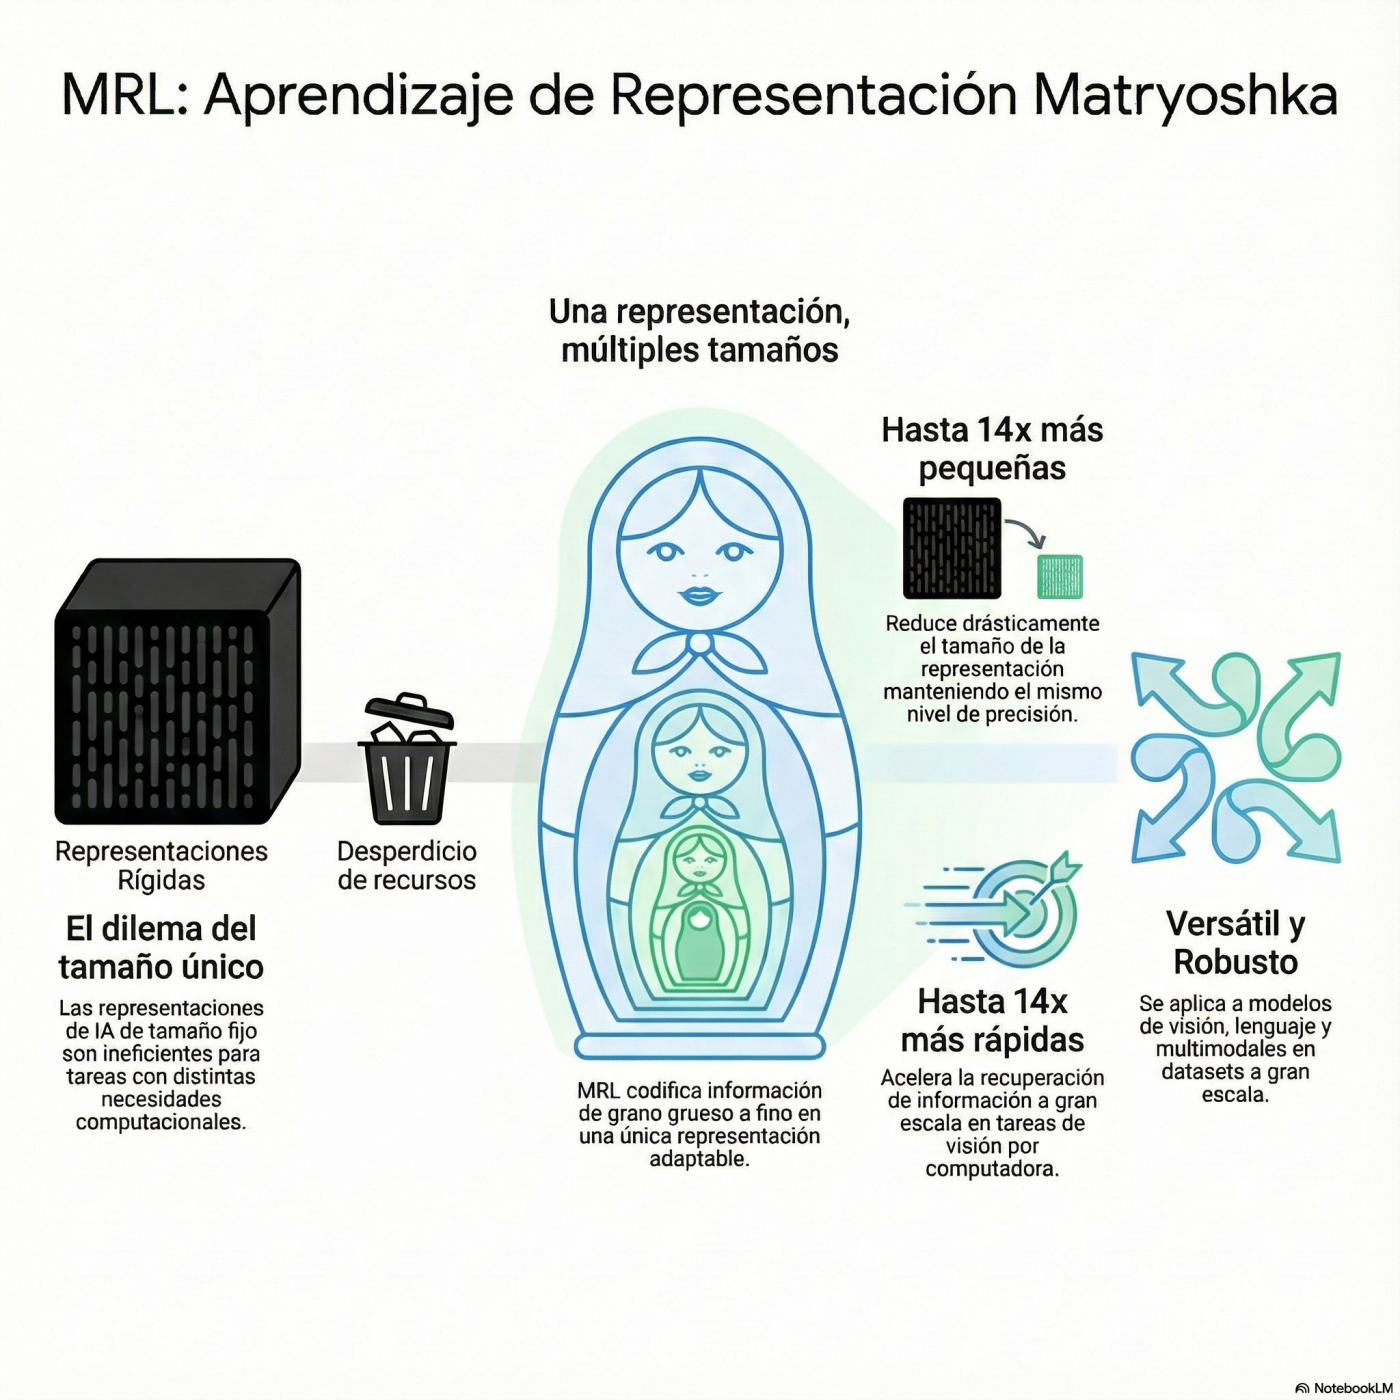
¿Te imaginas entrenar una IA una sola vez y que su “cerebro” pueda adaptarse dinámicamente a cualquier dispositivo, desde un potente servidor hasta un móvil antiguo? 📱💻 En este episodio desgranamos el paper “Matryoshka Representation Learning”, una propuesta fascinante que rompe con la rigidez de los modelos tradicionales. Al igual que las famosas muñecas rusas 🪆, esta técnica permite crear embeddings anidados que codifican la información en diferentes niveles de granularidad, logrando una flexibilidad inédita sin coste adicional durante la inferencia. Descubre cómo es posible conseguir representaciones hasta 14 veces más ligeras manteniendo la misma precisión en clasificación y logrando una aceleración masiva en tareas de recuperación de datos 🚀. Analizamos por qué esta arquitectura “elástica” se integra a la perfección con modelos de visión y lenguaje modernos (como BERT o ViT) y cómo resuelve el dilema de los recursos limitados sin sacrificar la robustez. ¡Dale al play para entender cómo esconder IAs gigantes en espacios diminutos! 🎧✨ Fuentes: • Paper: Matryoshka Representation Learning (arXiv)