
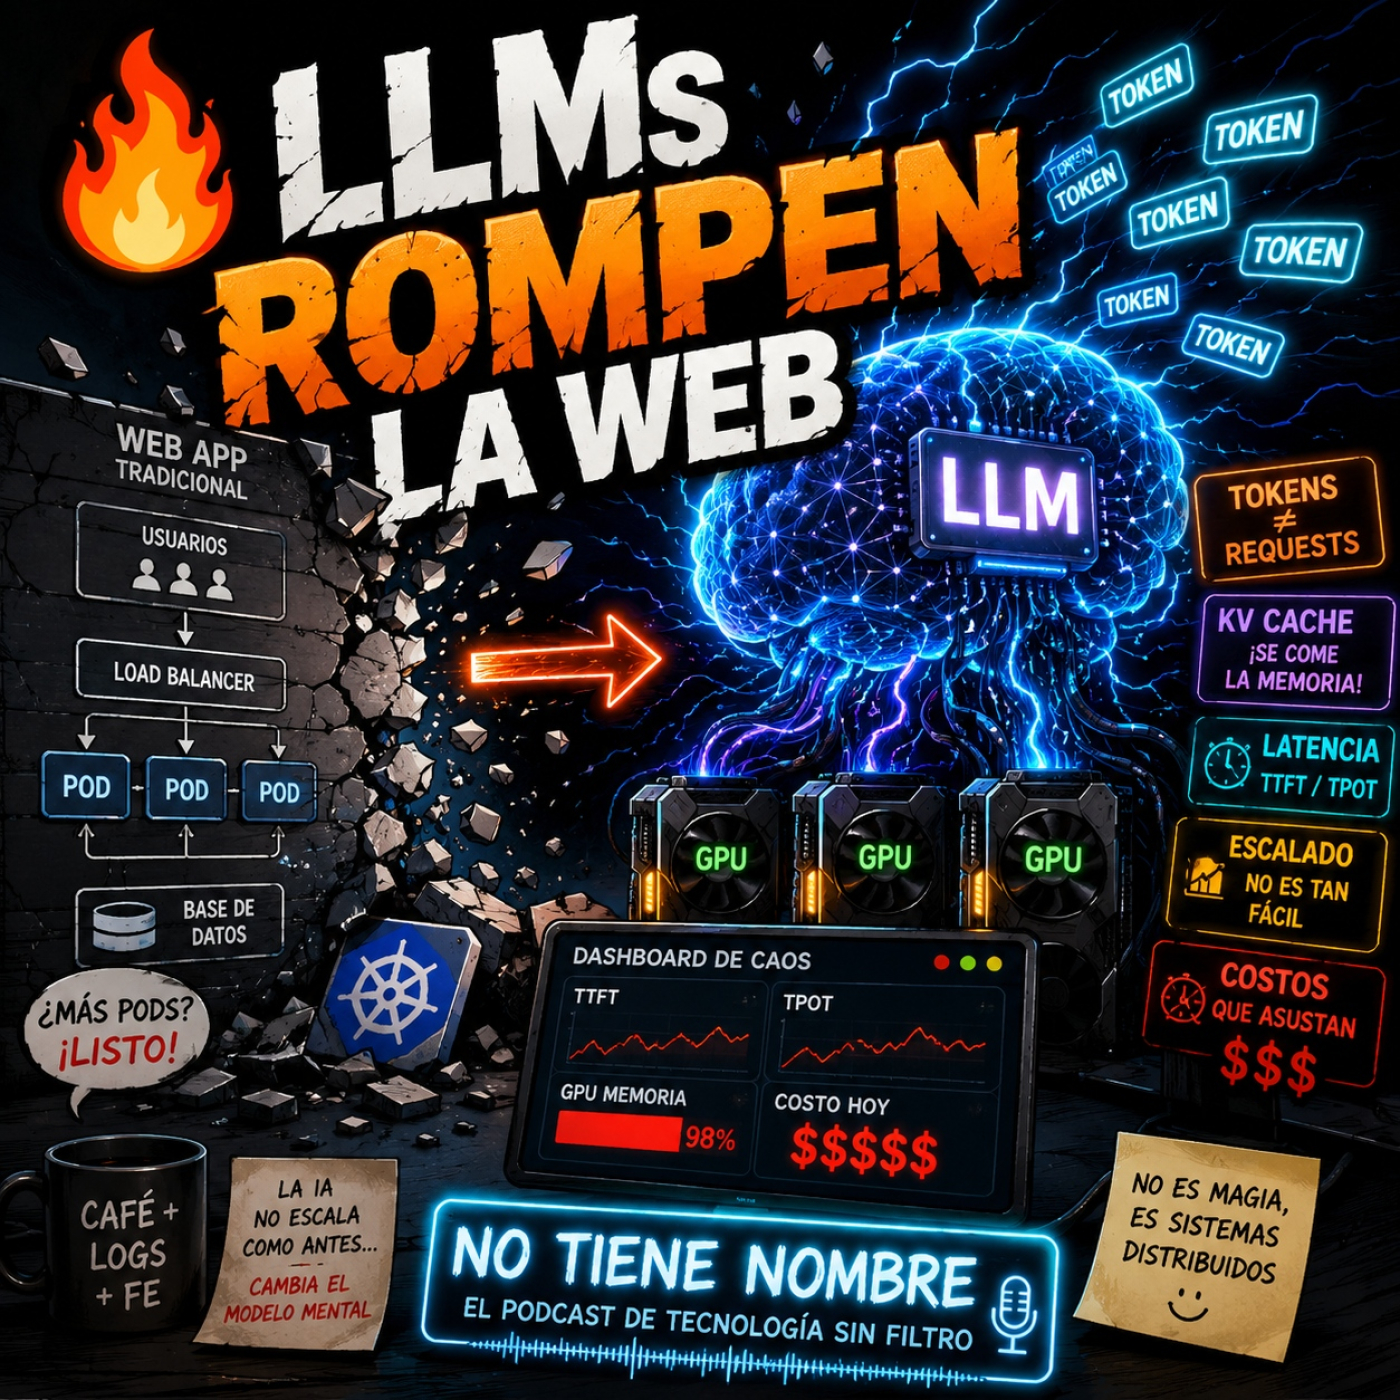
NTN 520 - Escalar IA Duele
Sobre este episodio
¡Vótame en los Premios iVoox 2026! Servir un LLM no es como escalar una web app normal. Hablamos de tokens, GPUs, KV cache, latencia, costos y por qué “agregar más pods” ya no salva a nadie. Fuentes: • https://www.dheeth.blog/llm-serving-is-not-normal-web-serving/ • https://arxiv.org/abs/2309.06180 • https://kubernetes.io/docs/concepts/workloads/autoscaling/horizontal-pod-autoscale/