
E032_La destilación del conocimiento en los modelos de lenguaje grandes (LLM)
Sobre este episodio
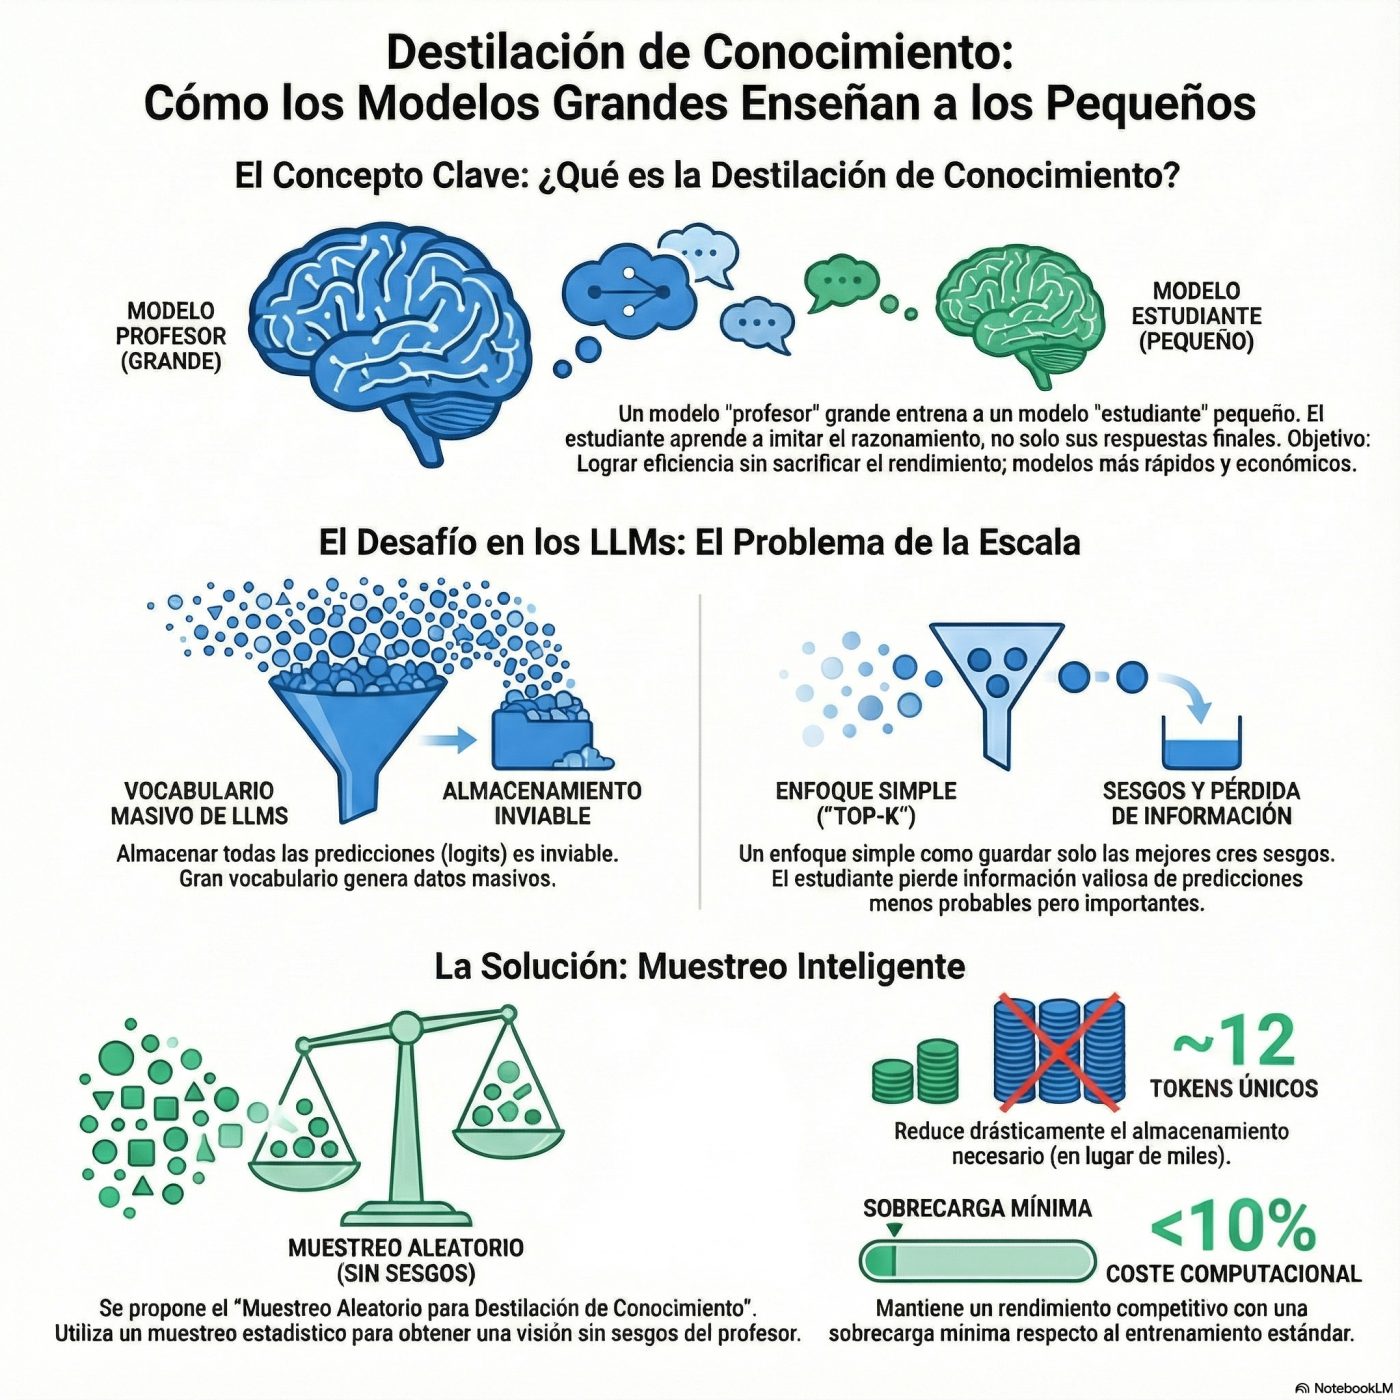
¿Alguna vez te has preguntado cómo logramos que los gigantescos Modelos de Lenguaje Grande (LLMs) quepan en dispositivos más pequeños sin perder su “inteligencia”? 🧠✨ En este episodio desglosamos el fascinante mundo de la Knowledge Distillation (Destilación de Conocimiento), la técnica maestra que transfiere la sabiduría de un modelo “profesor” masivo a un “alumno” ágil y eficiente. 📱 Pero hay una trampa en los métodos actuales: descubriremos por qué los atajos populares, como guardar solo las probabilidades más altas (Top-K), están creando modelos sesgados y peligrosamente sobreconfiados en sus errores. 🚫🔍 Nos sumergimos en la última investigación de 2025, “Sparse Logit Sampling”, que propone una solución elegante y poderosa: la Random Sampling Knowledge Distillation. 📉💡 Analizamos cómo este nuevo enfoque utiliza el muestreo por importancia para lograr estimaciones imparciales almacenando apenas 12 tokens (frente a los miles habituales), reduciendo drásticamente el almacenamiento sin sacrificar la calidad del aprendizaje. 🚀 Dale al play para entender cómo esta técnica preserva la información crítica de la “cola” de probabilidades y está redefiniendo la eficiencia en la IA con un coste computacional mínimo. 🎧🔥 Enlaces relevantes: • Paper original: Sparse Logit Sampling: Accelerating Knowledge Distillation in LLMs (ArXiv) • Conceptos básicos: Destilación de Conocimiento (Wikipedia)