
Portada de BIMPRAXIS

E069_Caché_semántica_y_de_prompts_en_IA

· 23 min · Episodio 69

Nadie ha valorado este episodio todavía Tu nota:

Sobre este episodio

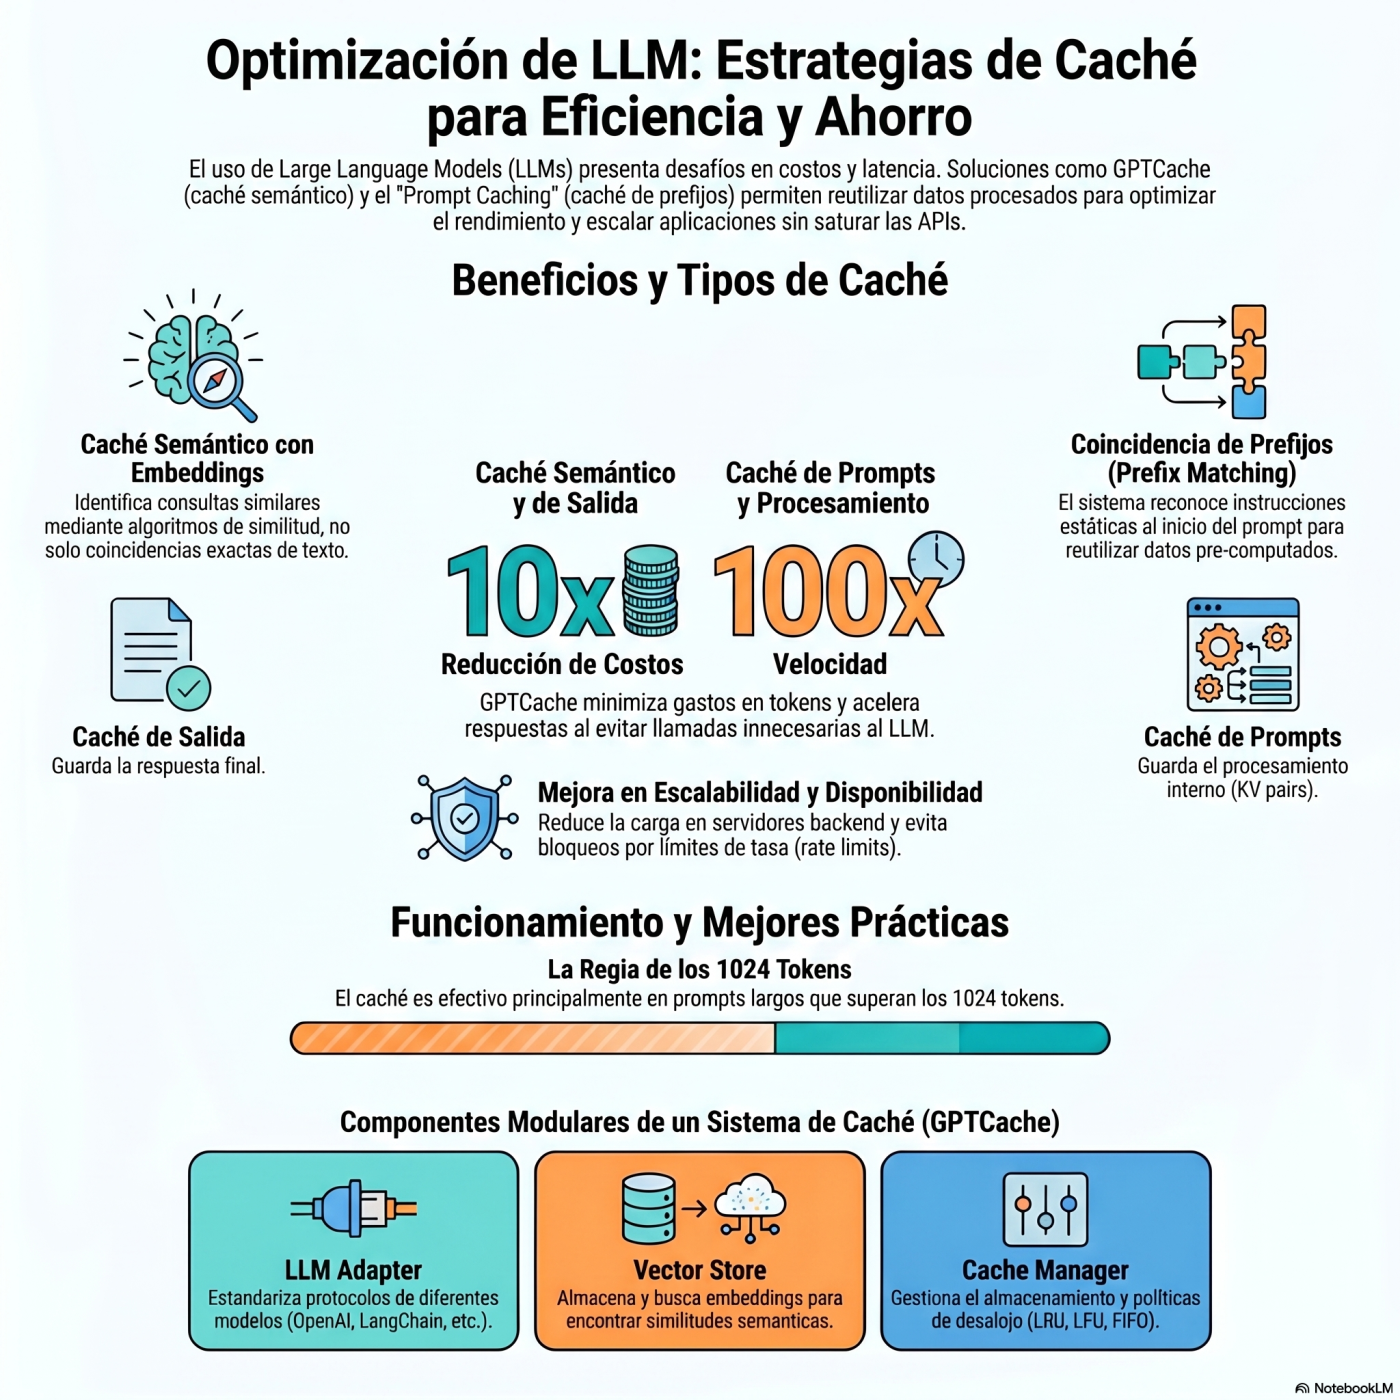
Descripción del Episodio En este episodio de BIMPRAXIS, exploramos cómo las memorias caché están revolucionando la forma en que los modelos de lenguaje generativo masivo funcionan, ahorrando tiempo y dinero. Analizamos dos enfoques clave: la caché semántica para respuestas finales y el almacenamiento en caché del procesamiento de entrada, o prompts. Examinamos cómo GPT-Caché y la documentación de IBM Technology ofrecen soluciones innovadoras para optimizar el rendimiento y reducir costos. Además, discutimos la importancia de la calibración y la monitorización en la implementación de estas tecnologías.

Últimos episodios de BIMPRAXIS

  1. E118_Khoj AI + Pipali + GBrain El Segundo Cerebro Digital de Código Abierto

    20 de agosto de 2026 · 20 min

  2. E117_Domina NotebookLM con un Servidor MCP y Funciones Ocultas de IA

    18 de agosto de 2026 · 27 min

  3. E116_Tiiny, un gadget de bolsillo con 128GB de inferencia

    16 de agosto de 2026 · 17 min

  4. E115_Neuralwatt provee inferencia IA pero cobra por kWh en vez de por tokens y sale baratísimo

    13 de agosto de 2026 · 27 min

  5. E114_Microsoft And DeepSeek Are Launching New AI Together

    11 de agosto de 2026 · 18 min