
E073_TurboQuant_Comprimir_la_KV-Cache_de_contexto
Sobre este episodio
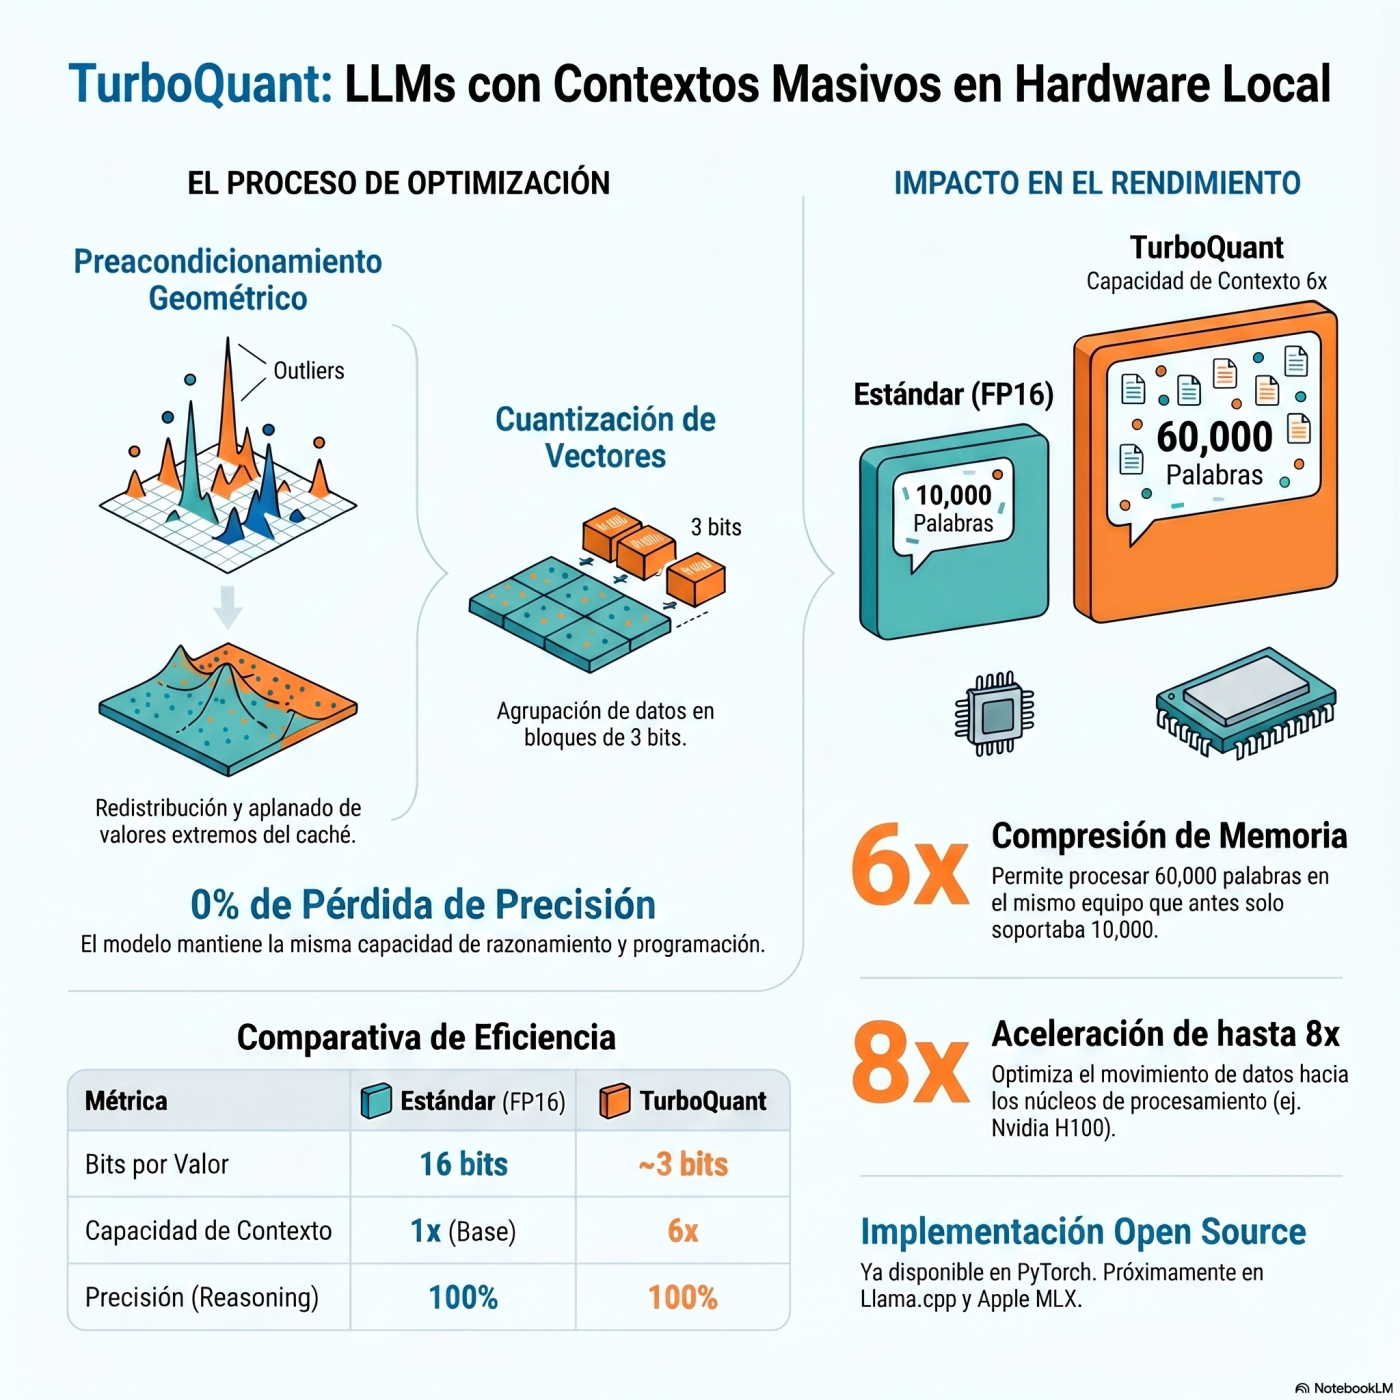
Episodio de BIMPRAXIS: TurboQuant, la técnica de Google para correr modelos de lenguaje gigantes en cualquier ordenador TurboQuant, una innovadora técnica desarrollada por Google, permite ejecutar modelos de lenguaje gigantes en cualquier ordenador sin perder precisión. Esta técnica logra comprimir el espacio necesario hasta seis veces y acelerar el proceso general, revolucionando la forma en que se procesan los modelos de inteligencia artificial. Con TurboQuant, se puede procesar una cantidad mucho mayor de información sin necesidad de hardware adicional, lo que abre nuevas posibilidades para la investigación y el desarrollo de aplicaciones de IA.