
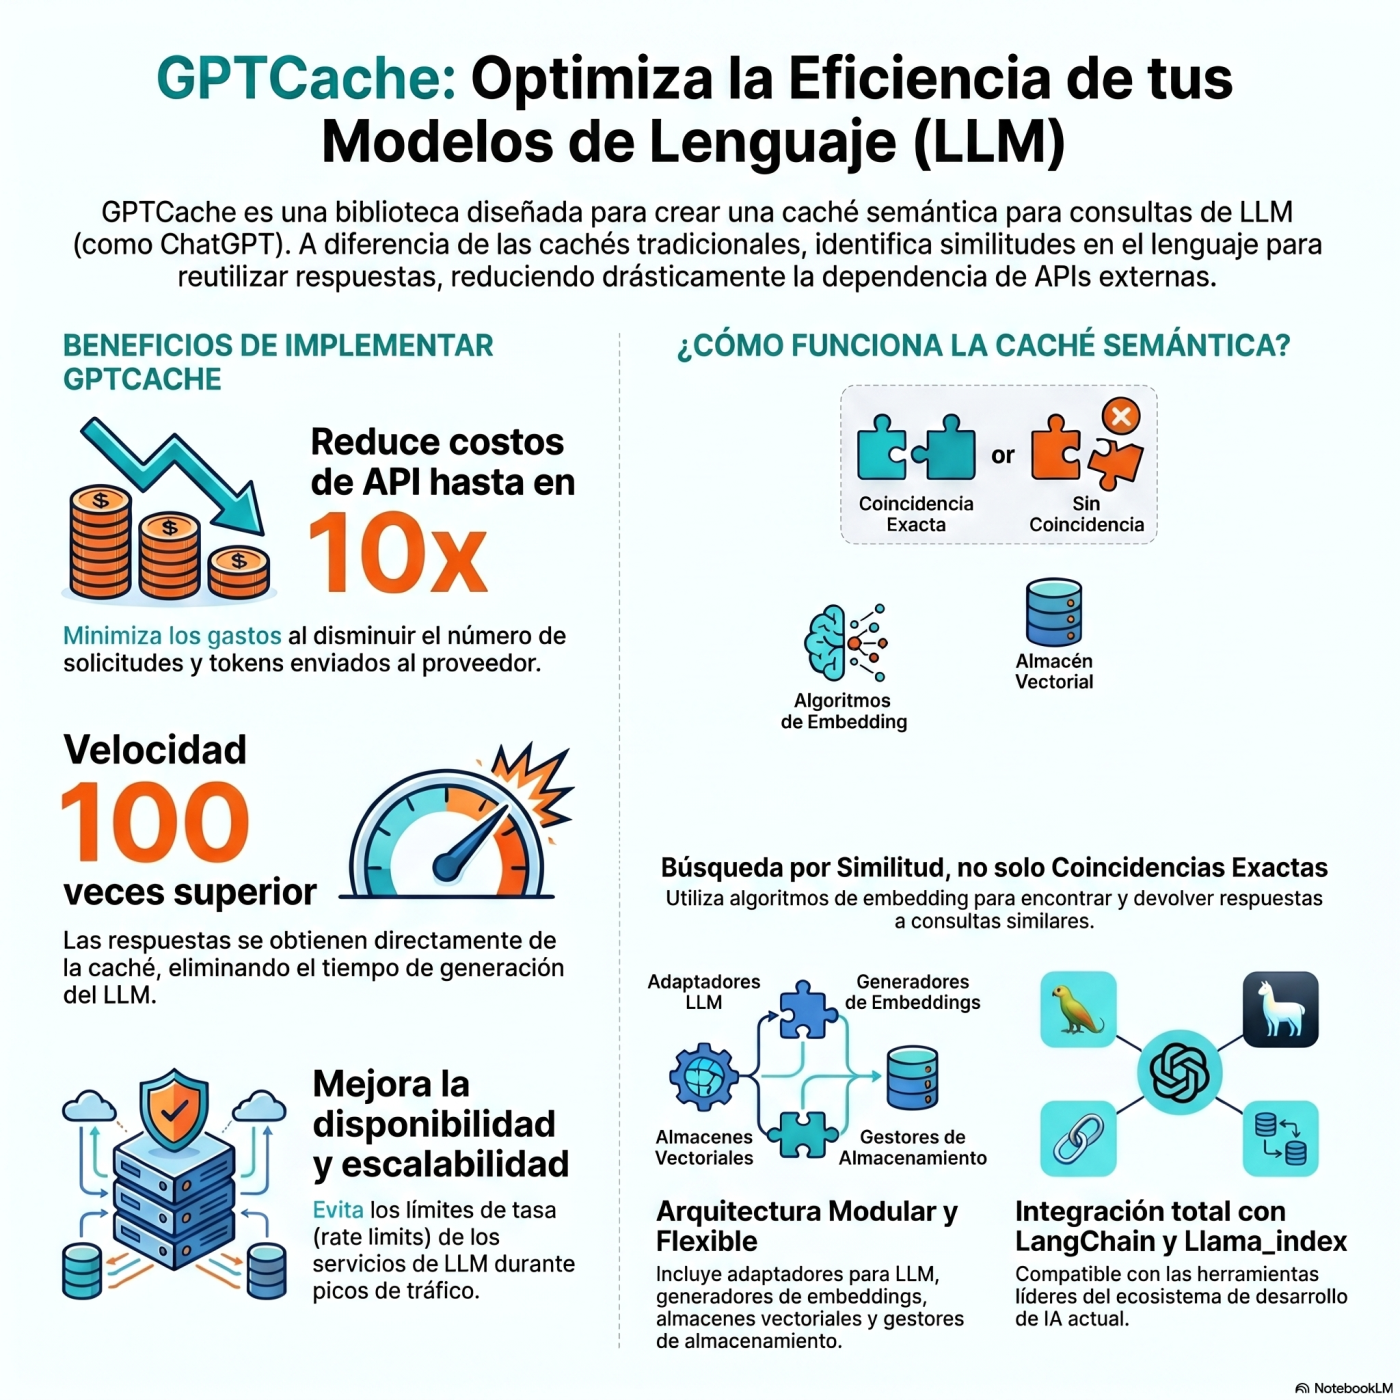
E092_GPTCache. Memoria Semántica para modelos LLM
Sobre este episodio
Episodio de BIMPRAXIS: Reduciendo costes y tiempos de espera con GPT-Caché El podcast BIMPRAXIS explora la intersección de la arquitectura, ingeniería, construcción y la inteligencia artificial. En este episodio, se profundiza en cómo reducir drásticamente los costes y tiempos de espera de los grandes modelos de lenguaje gracias a GPT-Caché, un proyecto de código abierto que actúa como capa intermedia entre la aplicación y el modelo de lenguaje externo. GPT-Caché promete reducir el coste de la API hasta 10 veces y acelerar la velocidad de respuesta hasta 100 veces, mediante la construcción de una caché semántica que evita el trabajo redundante y reduce la latencia.